Công Cụ Audit SEO Tự Động - Python Script
OCR PDF bằng Python: trích xuất văn bản từ PDF quét qua Google Vision, sửa lỗi chính tả, xuất Google Docs chỉnh sửa được.
Mô tả chi tiết giải pháp
Công Cụ Audit SEO Tự Động - Python Script giúp bạn số hóa tài liệu giấy, PDF quét, sách cũ thành văn bản thuần chỉnh sửa được — tự động nhận diện chữ qua Google Cloud Vision OCR, sửa lỗi chính tả và xuất ra Google Docs, không cần gõ lại một chữ nào.
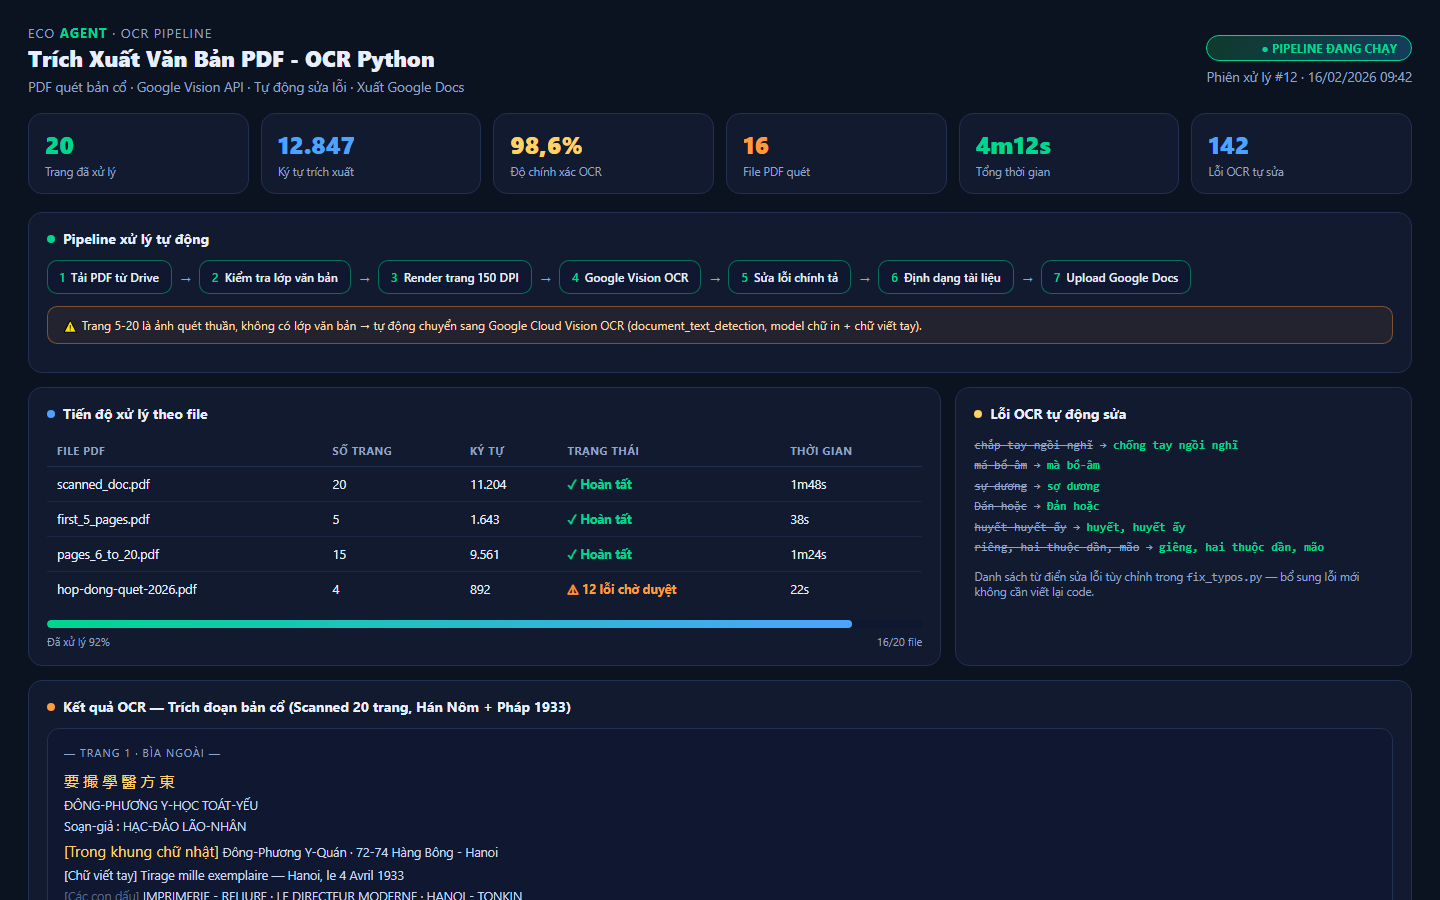
Thay vì ngồi gõ lại hàng chục trang tài liệu quét, hợp đồng giấy, hay những cuốn sách cổ chữ Hán Nôm, bạn chạy vài lệnh Python — pipeline tự tải file, kiểm tra lớp văn bản, render trang, gọi OCR, sửa lỗi và dọn văn bản sẵn sàng.
🎯 Bài toán số hóa tài liệu
- 📄 PDF quét chỉ là ảnh — copy, tìm kiếm, chỉnh sửa đều không được, phải gõ lại tay từng trang.
- ⏳ Gõ lại tài liệu dài tốn hàng giờ, dễ sai sót, mỏi mắt khi đối chiếu.
- 📚 Sách cũ, tài liệu Hán Nôm không gõ lại được — cần nhận diện đa ngôn ngữ chuyên sâu.
- 🔤 OCR thô đầy lỗi — chữ sai lệch ("chắp tay" thành "chắp tay...") phải sửa thủ công từng chỗ.
- 📤 Kết quả rời rạc — không có văn bản chuẩn để chia sẻ, chỉnh sửa, trích dẫn.
Tool tự động hóa toàn bộ quy trình — từ file quét thô đến Google Docs hoàn chỉnh, chỉ trong vài phút.
✅ Tính năng chính
1. Kiểm tra lớp văn bản tự động
extract_text.py mở PDF bằng PyMuPDF, đọc thử các trang đầu và báo chính xác trang nào có văn bản, trang nào là ảnh quét thuần — quyết định đúng hướng xử lý mà không cần đoán.
2. OCR ảnh quét qua Google Vision
test_vision.py render từng trang thành ảnh 150 DPI rồi gọi Google Cloud Vision document_text_detection — nhận diện chữ in, chữ viết tay, nhiều ngôn ngữ trong cùng trang (Hán, Pháp, Việt cổ).
3. Tách trang theo nhu cầu
Xử lý từng khoảng trang riêng (5 trang đầu, trang 6-20...) bằng extract_5_pages.py / extract_6_to_20.py — chạy thử trên vài trang trước khi xử lý cả cuốn, tiết kiệm tài nguyên.
4. Tự động sửa lỗi chính tả
fix_typos.py kèm từ điển sửa lỗi OCR thường gặp: "chắp tay" → "chống tay", "sự dương" → "sợ dương", "má bổ-âm" → "mà bổ-âm". Thêm lỗi mới chỉ cần thêm một dòng vào danh sách.
5. Định dạng lại tài liệu
format_docs.py tự dò và chuẩn hóa cấu trúc: tách đoạn, phân biệt tiêu đề, sắp xếp lại các khối văn bản theo đúng thứ tự trang.
6. Xuất Google Docs hoàn chỉnh
upload_to_docs.py dựng văn bản có cấu trúc trên Google Docs (đánh dấu trang, ghi chú chữ viết tay, con dấu) — cả team chỉnh sửa, chia sẻ, trích dẫn ngay, không cần chuyển đổi.
📊 Bảng so sánh: gõ lại tay vs Tool OCR
| Tiêu chí | Gõ lại tay | Tool OCR Python |
|---|---|---|
| 20 trang PDF quét | 4-6 giờ, dễ sai | Chưa đầy 5 phút |
| Sách Hán Nôm / chữ viết tay | Gần như bất khả thi | Vision OCR đa ngôn ngữ |
| Sửa lỗi nhập liệu | Sót lỗi, phải rà lại | Từ điển tự sửa + chờ duyệt |
| Kết quả chia sẻ | File .docx gửi qua lại | Google Docs chỉnh sửa trực tiếp |
| Chi phí | Nhân công gõ thuê | Mã nguồn mua 1 lần |
👥 Ai nên dùng?
- Văn phòng luật, kế toán — số hóa hợp đồng giấy, hồ sơ quét để tìm kiếm và soạn thảo.
- Thư viện, nhà nghiên cứu — số hóa sách cũ, tài liệu Hán Nôm, bản in xưa.
- Doanh nghiệp có kho tài liệu giấy — chuyển toàn bộ hồ sơ thành văn bản số tra cứu được.
💎 Vì sao chọn giải pháp này?
- ⚡ Trọn pipeline 1 lệnh — từ file quét đến Google Docs không cần can thiệp tay.
- 💰 Mua 1 lần, dùng mãi — không thuê dịch vụ OCR theo trang.
- 🇻🇳 Tối ưu tiếng Việt — từ điển sửa lỗi tiếng Việt, giữ dấu chuẩn.
- 🔌 Dễ tùy chỉnh — code Python rõ ràng, thêm nguồn dữ liệu, thêm quy tắc sửa lỗi không cần viết lại.
- 📤 Google Docs tự nhiên — kết quả đã ở đúng nơi team làm việc.
🚀 Bắt đầu trong 10 phút
- Cài Python 3 và chạy 3 lệnh pip (PyMuPDF, Google Vision, Docs API).
- Điền thông tin service account + ID tài liệu Google Docs.
- Chạy thử trên vài trang đầu, xem văn bản nhận diện.
- Xử lý toàn bộ — nhận file văn bản + Google Docs hoàn chỉnh.
📦 Sản phẩm bao gồm
- Mã nguồn Python đầy đủ (OCR, sửa lỗi, format, upload Docs)
- Tài liệu hướng dẫn cài đặt từng bước bằng tiếng Việt
- Hỗ trợ cấu hình và bàn giao qua Zalo
Liên hệ ngay hôm nay để nhận tư vấn và dùng thử miễn phí
💬 Chat Zalo ngay